Guía de producto
Más allá de las restricciones de base de datos: prevención de registros de usuario duplicados con flujos de trabajo de verificación
Aprenda cómo combinar restricciones únicas de base de datos, operaciones atómicas y verificación de metadatos ayuda a prevenir registros de usuario duplicados.
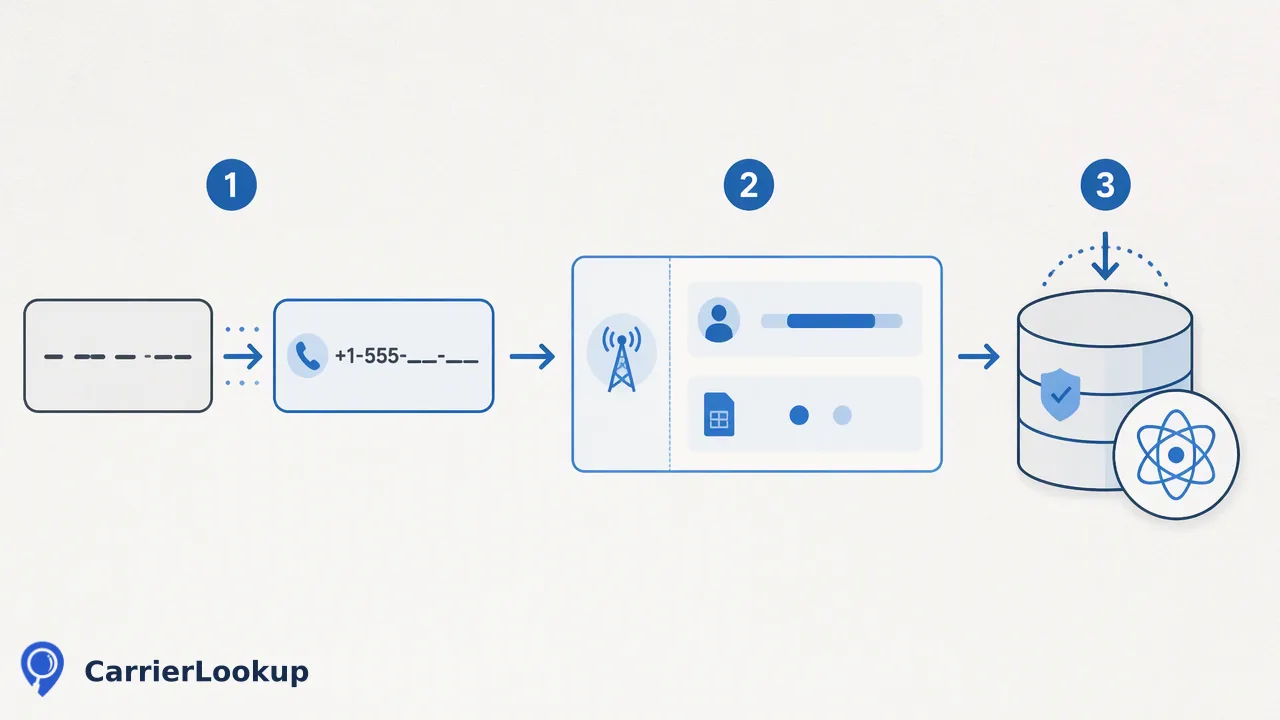
Una guía práctica sobre la prevención de registros de usuario duplicados mediante la combinación de restricciones únicas de base de datos y operaciones atómicas con normalización E.164 previa y metadatos de asignación del operador original.
La prevención de registros de usuario duplicados requiere una arquitectura de múltiples capas que combine restricciones de almacenamiento a nivel de base de datos con verificación de datos a nivel de aplicación. Las restricciones únicas de la base de datos actúan como la última línea de defensa estructural contra registros redundantes, pero depender únicamente de los errores de la base de datos genera fricción operativa durante el proceso de incorporación de alta concurrencia. Al introducir una validación previa —como el formato telefónico E.164 y las comprobaciones de metadatos de asignación del operador original—, los equipos de ingeniería filtran las entradas mal formadas o irrelevantes antes de la ejecución en la base de datos. Este flujo de trabajo combinado gestiona las condiciones de carrera mediante transacciones atómicas, reduce las excepciones del backend y respalda la integridad de los datos a largo plazo en los registros de usuarios de producción.
La arquitectura de múltiples capas para la integridad del registro
Un proceso de registro resiliente separa las responsabilidades entre la ingesta a nivel de aplicación y la persistencia en la capa de almacenamiento. La verificación a nivel de aplicación inspecciona la información de contacto entrante, estandariza los formatos de cadena y recopila telemetría antes de ejecutar cambios de estado. Esta capa preliminar reduce los viajes de ida y vuelta innecesarios a la base de datos y detecta errores de entrada comunes al inicio del ciclo de vida del usuario.
Los índices únicos de la base de datos sirven como una barrera inmutable contra identidades duplicadas. Incluso cuando los procesos de la aplicación superan la validación inicial, las presentaciones concurrentes dirigidas al mismo identificador pueden eludir las consultas de lectura estándar si los niveles de aislamiento son débiles. Confiar exclusivamente en la lógica de la aplicación conlleva riesgos de fallos de integridad bajo carga, mientras que confiar puramente en las restricciones de la base de datos obliga a los servicios posteriores a gestionar excepciones ruidosas de la base de datos. La integración de ambos enfoques crea un proceso equilibrado donde las comprobaciones de la aplicación optimizan el rendimiento y las restricciones de la base de datos mantienen la unicidad estructural.
Implementación de restricciones de almacenamiento y operaciones atómicas
En la capa de base de datos, definir restricciones únicas en identificadores principales, como números de teléfono normalizados o correos electrónicos, constituye la base de la consistencia de los datos. Cuando varios trabajadores de registro intentan escribir el mismo identificador simultáneamente, el motor de la base de datos utiliza estructuras de índice para hacer cumplir la unicidad.
Para agilizar la lógica de registro y minimizar la sobrecarga de los viajes de ida y vuelta, los equipos suelen implementar operaciones de base de datos atómicas como los patrones INSERT ... ON CONFLICT o UPSERT. La ejecución atómica evalúa la existencia y la persistencia dentro de una sola sentencia, cerrando la brecha entre las operaciones de lectura y escritura donde ocurren las condiciones de carrera. Cuando surge un conflicto de clave duplicada, el motor devuelve una violación de restricción predecible en lugar de generar un estado corrupto. Gestionar estos conflictos con elegancia en el código de la aplicación permite ofrecer una respuesta clara al usuario mientras se mantiene la base de datos limpia.
Reducción del ruido en el proceso con comprobaciones de metadatos previas
Antes de que los registros lleguen a las rutinas de inserción de la base de datos, la higienización de datos previa filtra las anomalías de formato y las inconsistencias estructurales. La normalización de las cadenas de entrada en formatos estándar, como ITU-T Recommendation E.164, garantiza que los números de teléfono compartan un formato internacional consistente con un signo más inicial, código de país y dígitos del suscriptor. Esta estandarización resuelve discrepancias superficiales, como prefijos troncales locales o diferencias de puntuación, que de otro modo podrían eludir las comparaciones de cadenas básicas.
Los equipos pueden enriquecer aún más esta fase previa revisando los metadatos de asignación del operador original a través del endpoint síncrono POST /api/v1/check de CarrierLookup. Esta comprobación devuelve la geografía de asignación, el tipo de línea y la red originalmente asignada para un identificador E.164. Debido a que el contexto de asignación permanece estático independientemente de la portabilidad posterior, proporciona detalles técnicos de referencia sobre los bloques de números. Incorporar señales de asignación en las etapas de validación temprana ayuda a los sistemas a categorizar el tráfico de registro entrante y organizar las reglas de enrutamiento antes de persistir los registros en el almacenamiento.
Gestión de la concurrencia y condiciones de carrera
En los sistemas de alta concurrencia, la gestión de intentos de registro simultáneos presenta claras compensaciones de rendimiento entre las consultas previas y la gestión de excepciones. Un problema arquitectónico común implica emitir una consulta de lectura previa SELECT para probar si existe un identificador de usuario, seguida de un INSERT condicional. En entornos distribuidos o multiproceso, dos solicitudes concurrentes pueden ejecutar la comprobación de lectura con éxito antes de que cualquiera realice la escritura, lo que provoca condiciones de carrera.
Equilibrar las comprobaciones de lectura con la gestión de excepciones requiere una arquitectura deliberada. Si bien el filtrado previo ligero descarta las cargas útiles mal formadas antes de tocar las tablas principales, el paso de persistencia debe tratar la restricción única de la base de datos como el árbitro autorizado. Los equipos de ingeniería deben diseñar el servicio de registro para capturar explícitamente las excepciones de violación de índice único. Al traducir los errores de conflicto de la base de datos en eventos de dominio o códigos de estado claros, el servicio mantiene un alto rendimiento sin bloquear tablas ni corromper las relaciones de las cuentas.
Preguntas frecuentes
¿Por qué las restricciones únicas de base de datos por sí solas son insuficientes para prevenir registros de usuario duplicados?
Las restricciones únicas detienen de manera fiable las filas duplicadas en la base de datos, pero actúan solo al final del ciclo de vida de la transacción. Depender totalmente de las colisiones en la base de datos obliga al motor de almacenamiento a procesar registros mal formados, no estandarizados o ruidosos. La integración de la normalización previa y la verificación de metadatos en etapas anteriores reduce la carga innecesaria de la base de datos, estandariza las variaciones de entrada y permite a los equipos resolver problemas de validación antes de que ocurran errores en la base de datos.
¿Cómo informa la metadatos de asignación del operador original a los flujos de trabajo de registro?
Los metadatos de asignación del operador original proporcionan un contexto estático de asignación de red, tipo de línea y geografía de numeración regional para un identificador. Al consultar estos datos de asignación mediante comprobaciones síncronas, los equipos de ingeniería obtienen un contexto estructural sobre el rango del número de teléfono. Este contexto respalda la clasificación automatizada del tráfico y las decisiones de enrutamiento interno junto con la validación principal de la base de datos.
¿Cuál es el papel de la normalización E.164 en la integridad de los datos?
La normalización de números convierte los números de teléfono al formato estándar especificado por ITU-T Recommendation E.164, que comprende un código de país y hasta quince dígitos. La normalización evita entradas duplicadas causadas por entradas de usuario inconsistentes, como espacios adicionales, guiones o prefijos nacionales, asegurando que los identificadores coincidan de manera consistente con las restricciones únicas de la base de datos.
Más información
Elija la información del producto que se ajuste al siguiente paso en su flujo de trabajo.