Produktleitfaden
Über Datenbank-Constraints hinaus: Vermeidung doppelter Benutzerregistrierungen durch Verifizierungs-Workflows
Erfahren Sie, wie die Kombination aus eindeutigen Datenbank-Constraints, atomaren Operationen und Metadaten-Verifizierung doppelte Registrierungen verhindert.
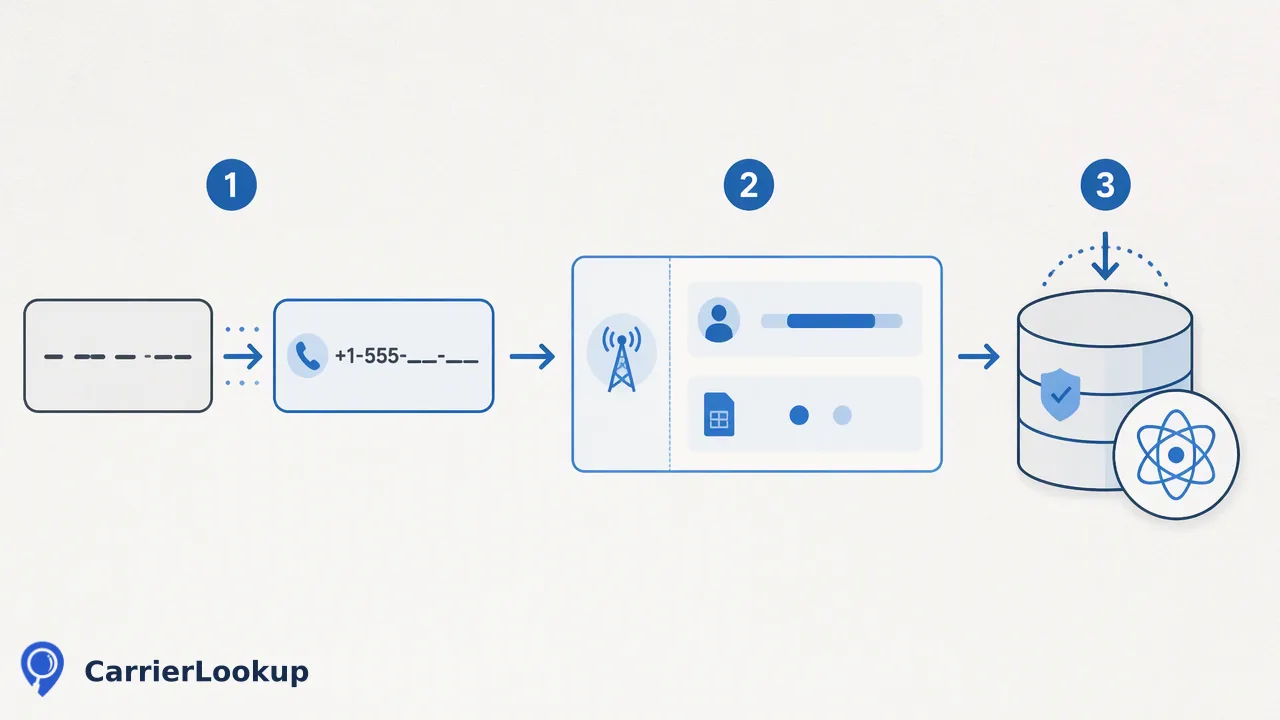
Ein praktischer Leitfaden zur Vermeidung doppelter Benutzerregistrierungen durch die Kombination von eindeutigen Datenbank-Constraints und atomaren Operationen mit E.164-Normalisierung und Metadaten zur ursprünglichen Netzbetreiberzuweisung.
Die Vermeidung doppelter Benutzerregistrierungen erfordert eine mehrschichtige Architektur, die Speicher-Constraints auf Datenbankebene mit Datenverifizierung auf Anwendungsebene verbindet. Eindeutige Datenbank-Constraints dienen als letzte strukturelle Verteidigungslinie gegen redundante Datensätze, doch die alleinige Abhängigkeit von Datenbankfehlern führt bei der Registrierung unter hoher Last zu operativer Reibung. Durch die Einführung einer Vorab-Validierung – wie etwa E.164-Telefonnummernformatierung und Abfrage der Metadaten zur ursprünglichen Netzbetreiberzuweisung – filtern Engineering-Teams fehlerhafte oder unbrauchbare Eingaben bereits vor der Datenbankausführung. Dieser kombinierte Workflow steuert Race Conditions durch atomare Transaktionen, reduziert Backend-Exceptions und unterstützt die langfristige Datenintegrität in Benutzerregistern.
Die mehrschichtige Architektur für Registrierungsintegrität
Eine robuste Registrierungspipeline trennt die Zuständigkeiten zwischen der Datenaufnahme auf Anwendungsebene und der Persistenz auf Speicherebene. Die Verifizierung auf Anwendungsebene prüft eingehende Kontaktinformationen, standardisiert Zeichenfolgenformate und sammelt Telemetriedaten, bevor Zustandsänderungen vorgenommen werden. Diese vorgelagerte Ebene reduziert unnötige Datenbankzugriffe und erkennt häufige Eingabefehler frühzeitig im Benutzerlebenszyklus.
Eindeutige Datenbank-Indizes dienen als unveränderliche Barriere gegen doppelte Identitäten. Selbst wenn Anwendungsprozesse die erste Validierung bestehen, können gleichzeitige Anfragen, die auf denselben Identifikator abzielen, Standard-Leseabfragen umgehen, wenn die Isolationsstufen schwach sind. Die ausschließliche Abhängigkeit von Anwendungslogik riskiert Integritätsfehler unter Last, während die reine Abhängigkeit von Datenbank-Constraints nachgelagerte Dienste dazu zwingt, unsaubere Datenbank-Exceptions zu verarbeiten. Die Integration beider Ansätze schafft eine ausgewogene Pipeline, in der Anwendungsprüfungen den Durchsatz optimieren und Datenbank-Constraints die strukturelle Eindeutigkeit wahren.
Implementierung von Speicher-Constraints und atomaren Operationen
Auf Datenbankebene bildet die Definition eindeutiger Constraints für primäre Identifikatoren wie normalisierte Telefonnummern oder E-Mails das Fundament der Datenkonsistenz. Wenn mehrere Registrierungsprozesse gleichzeitig versuchen, denselben Identifikator zu schreiben, nutzt die Datenbank-Engine Indexstrukturen, um die Eindeutigkeit zu erzwingen.
Um die Registrierungslogik zu optimieren und den Overhead durch Datenbankzugriffe zu minimieren, implementieren Teams häufig atomare Datenbankoperationen wie INSERT ... ON CONFLICT oder UPSERT-Muster. Die atomare Ausführung bewertet Existenz und Persistenz innerhalb einer einzigen Anweisung und schließt die Lücke zwischen Lese- und Schreibvorgängen, in der Race Conditions auftreten können. Wenn ein Konflikt bei einem eindeutigen Schlüssel auftritt, gibt die Engine eine vorhersehbare Constraint-Verletzung zurück, anstatt einen korrupten Zustand zu erzeugen. Der saubere Umgang mit diesen Konflikten im Anwendungscode unterstützt ein klares Feedback an den Benutzer und hält die Datenbank sauber.
Reduzierung von Pipeline-Rauschen mit Vorab-Metadatenprüfungen
Bevor Datensätze die Datenbank-Einfügeroutinen erreichen, filtern Vorab-Datenbereinigungen Formatierungsanomalien und strukturelle Inkonsistenzen heraus. Die Normalisierung von Eingabezeichenfolgen in Standardformate, wie etwa ITU-T Recommendation E.164, stellt sicher, dass Telefonnummern ein konsistentes internationales Format mit einem führenden Pluszeichen, Ländercode und Teilnehmernummern aufweisen. Diese Standardisierung löst oberflächliche Diskrepanzen, wie lokale Präfixe oder Zeichensetzung, die andernfalls einfache Zeichenfolgenvergleiche umgehen könnten.
Teams können diese Vorab-Phase weiter anreichern, indem sie die Metadaten zur ursprünglichen Netzbetreiberzuweisung über den synchronen POST /api/v1/check Endpunkt von CarrierLookup überprüfen. Diese Prüfung liefert die Zuweisungsgeografie, den Leitungstyp und das ursprünglich zugewiesene Netzwerk für einen E.164-Identifikator. Da der Zuweisungskontext unabhängig von einer späteren Portierung statisch bleibt, liefert er technische Basisdetails über Nummernblöcke. Die Einbindung von Zuweisungssignalen in frühe Validierungsphasen hilft Systemen, eingehenden Registrierungsverkehr zu kategorisieren und Routing-Regeln zu organisieren, bevor Datensätze im Speicher persistiert werden.
Verwaltung von Nebenläufigkeit und Race Conditions
In Systemen mit hoher Nebenläufigkeit stellt die Handhabung gleichzeitiger Registrierungsversuche deutliche Leistungsabwägungen zwischen Vorab-Abfragen und Exception-Management dar. Ein häufiges Architekturproblem besteht darin, eine SELECT-Vorab-Abfrage durchzuführen, um zu testen, ob ein Benutzeridentifikator existiert, gefolgt von einem bedingten INSERT. In verteilten oder Multithread-Umgebungen können zwei gleichzeitige Anfragen die Leseprüfung erfolgreich ausführen, bevor eine der beiden den Schreibvorgang durchführt, was Race Conditions auslöst.
Das Ausbalancieren von Leseprüfungen gegenüber der Fehlerbehandlung erfordert eine bewusste Architektur. Während leichtgewichtige Vorab-Filter fehlerhafte Payloads verwerfen, bevor sie die Primärtabellen berühren, muss der Persistenzschritt das eindeutige Datenbank-Constraint als maßgebliche Instanz behandeln. Engineering-Teams sollten den Registrierungsdienst so gestalten, dass er Verletzungen des eindeutigen Index explizit abfängt. Durch die Übersetzung von Datenbank-Konfliktfehlern in saubere Domain-Ereignisse oder Statuscodes behält der Dienst einen hohen Durchsatz bei, ohne Tabellen zu sperren oder Kontobeziehungen zu korrumpieren.
FAQ
Warum reichen eindeutige Datenbank-Constraints allein nicht aus, um doppelte Benutzerregistrierungen zu verhindern?
Eindeutige Constraints stoppen zuverlässig doppelte Datenbankzeilen, wirken jedoch erst am Ende des Transaktionslebenszyklus. Die ausschließliche Abhängigkeit von Datenbankkollisionen zwingt die Speicher-Engine dazu, fehlerhafte, nicht standardisierte oder unbrauchbare Datensätze zu verarbeiten. Die Integration von Vorab-Normalisierung und Metadaten-Verifizierung reduziert die unnötige Datenbanklast, standardisiert Eingabevariationen und ermöglicht es Teams, Validierungsprobleme zu lösen, bevor Datenbankfehler auftreten.
Wie informieren Metadaten zur ursprünglichen Netzbetreiberzuweisung Registrierungs-Workflows?
Metadaten zur ursprünglichen Netzbetreiberzuweisung liefern statischen Kontext zur Netzwerkzuordnung, zum Leitungstyp und zur regionalen Nummerierungsgeografie für einen Identifikator. Durch die Abfrage dieser Zuweisungsdaten mittels synchroner Prüfungen erhalten Engineering-Teams strukturellen Kontext zum Telefonnummernbereich. Dieser Kontext unterstützt die automatisierte Verkehrstriage und interne Routing-Entscheidungen neben der primären Datenbankvalidierung.
Welche Rolle spielt die E.164-Normalisierung bei der Datenintegrität?
Die Nummernnormalisierung konvertiert Telefonnummern in das durch ITU-T Recommendation E.164 spezifizierte Standardformat, das aus einem Ländercode und bis zu fünfzehn Ziffern besteht. Die Normalisierung verhindert doppelte Einträge, die durch inkonsistente Benutzereingaben wie zusätzliche Leerzeichen, Bindestriche oder nationale Präfixe verursacht werden, und stellt sicher, dass Identifikatoren konsistent mit eindeutigen Datenbank-Constraints abgeglichen werden.
Mehr erfahren
Wählen Sie die Produktinformationen, die zum nächsten Schritt in Ihrem Workflow passen.