Orientação de produto
Além das restrições de banco de dados: prevenindo registros duplicados de usuários com fluxos de trabalho de verificação
Saiba como combinar restrições de unicidade, operações atômicas e verificação de metadados para prevenir registros duplicados de usuários.
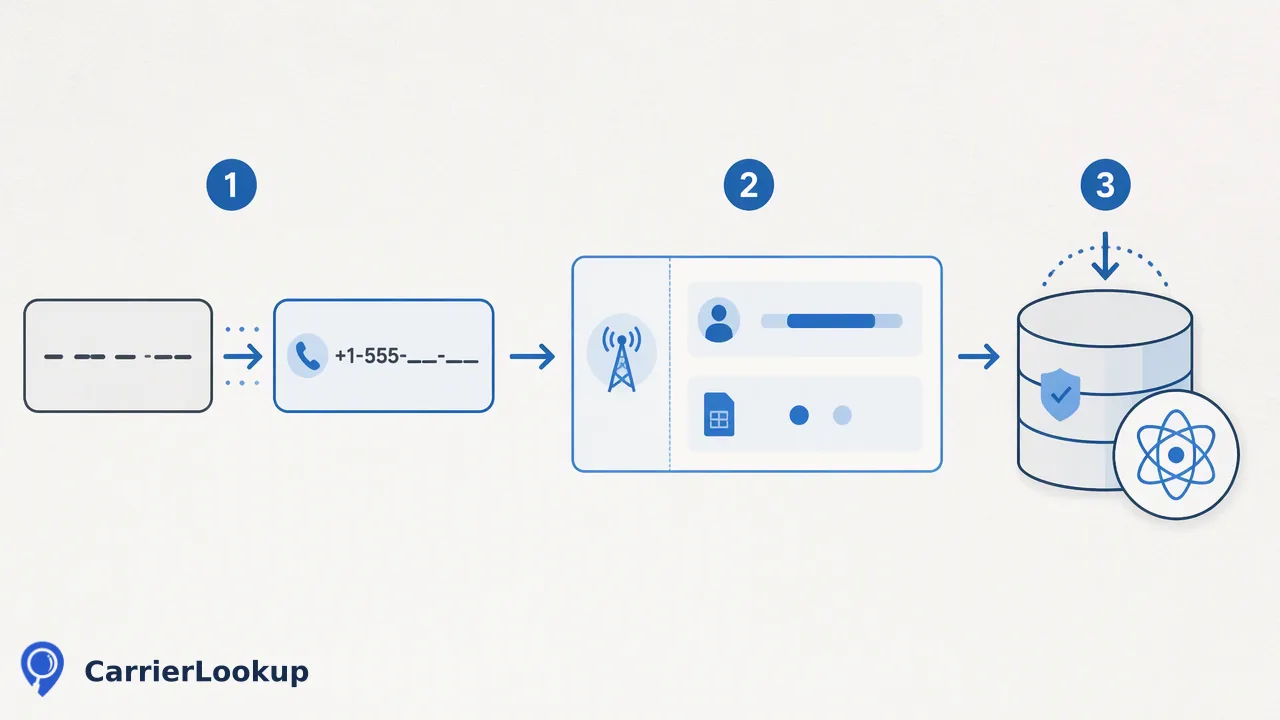
Um guia prático sobre como prevenir registros duplicados de usuários combinando restrições de unicidade de banco de dados e operações atômicas com a normalização E.164 pré-envio e metadados de alocação da operadora original.
Prevenir registros duplicados de usuários exige uma arquitetura multicamadas que combine restrições de armazenamento no nível do banco de dados com a verificação de dados no nível da aplicação. As restrições de unicidade do banco de dados atuam como a linha de defesa estrutural final contra registros redundantes, mas depender exclusivamente de erros de banco de dados cria atrito operacional durante o onboarding de alta concorrência. Ao introduzir a validação pré-envio — como a formatação de telefone E.164 e verificações de metadados de alocação da operadora original — as equipes de engenharia filtram entradas malformadas ou ruidosas antes da execução no banco de dados. Esse fluxo de trabalho combinado gerencia condições de corrida por meio de transações atômicas, reduz exceções no backend e apoia a integridade dos dados a longo prazo em registros de usuários de produção.
A arquitetura multicamadas para a integridade do registro
Um pipeline de registro resiliente separa as responsabilidades entre a ingestão no nível da aplicação e a persistência na camada de armazenamento. A verificação no nível da aplicação inspeciona as informações de contato recebidas, padroniza formatos de string e coleta telemetria antes de executar alterações de estado. Essa camada preliminar reduz idas e vindas desnecessárias ao banco de dados e detecta erros comuns de entrada no início do ciclo de vida do usuário.
Os índices de unicidade do banco de dados servem como uma barreira imutável contra identidades duplicadas. Mesmo quando os processos da aplicação passam pela validação inicial, envios simultâneos direcionados ao mesmo identificador podem passar por consultas de leitura padrão se os níveis de isolamento forem fracos. Depender exclusivamente da lógica da aplicação arrisca falhas de integridade sob carga, enquanto depender puramente de restrições de banco de dados força os serviços downstream a lidar com exceções ruidosas do banco de dados. Integrar ambas as abordagens cria um pipeline equilibrado, onde as verificações da aplicação otimizam o throughput e as restrições do banco de dados mantêm a unicidade estrutural.
Implementando restrições de armazenamento e operações atômicas
Na camada do banco de dados, definir restrições de unicidade em identificadores primários, como números de telefone normalizados ou e-mails, forma a base da consistência dos dados. Quando vários processos de registro tentam gravar o mesmo identificador simultaneamente, o motor do banco de dados usa estruturas de índice para impor a unicidade.
Para otimizar a lógica de registro e minimizar a sobrecarga de consultas, as equipes frequentemente implementam operações atômicas de banco de dados, como padrões INSERT ... ON CONFLICT ou UPSERT. A execução atômica avalia a existência e a persistência em uma única instrução, fechando a lacuna entre as operações de leitura e escrita onde ocorrem condições de corrida. Quando surge um conflito de chave duplicada, o motor retorna uma violação de restrição previsível em vez de gerar um estado corrompido. Lidar com esses conflitos de forma elegante no código da aplicação apoia um feedback claro ao usuário, mantendo o banco de dados limpo.
Reduzindo o ruído no pipeline com verificações de metadados pré-envio
Antes que os registros cheguem às rotinas de inserção do banco de dados, a higienização de dados pré-envio filtra anomalias de formatação e inconsistências estruturais. Normalizar strings de entrada em formatos padrão, como a ITU-T Recommendation E.164, garante que os números de telefone compartilhem um formato internacional consistente com um sinal de mais, código do país e dígitos do assinante. Essa padronização resolve discrepâncias superficiais, como prefixos locais ou diferenças de pontuação, que de outra forma poderiam ignorar comparações básicas de strings.
As equipes podem enriquecer ainda mais essa fase de pré-envio revisando os metadados de alocação da operadora original por meio do endpoint síncrono POST /api/v1/check do CarrierLookup. Essa verificação retorna a geografia de alocação, o tipo de linha e a rede originalmente atribuída para um identificador E.164. Como o contexto de alocação permanece estático independentemente da portabilidade subsequente, ele fornece detalhes técnicos básicos sobre blocos de números. Incorporar sinais de alocação em estágios iniciais de validação ajuda os sistemas a categorizar o tráfego de registro recebido e organizar regras de roteamento antes de persistir os registros no armazenamento.
Gerenciando concorrência e condições de corrida
Em sistemas de alta concorrência, lidar com tentativas de registro simultâneas apresenta compensações de desempenho distintas entre consultas de pré-envio e gerenciamento de exceções. Um problema arquitetural comum envolve emitir uma consulta de leitura SELECT de pré-envio para testar se um identificador de usuário existe, seguida por um INSERT condicional. Em ambientes distribuídos ou multithread, duas solicitações simultâneas podem executar a verificação de leitura com sucesso antes que qualquer uma realize a escrita, desencadeando condições de corrida.
Equilibrar verificações de leitura com o tratamento de exceções requer uma arquitetura deliberada. Embora a filtragem de pré-envio leve descarte cargas úteis malformadas antes de tocar nas tabelas primárias, a etapa de persistência deve tratar a restrição de unicidade do banco de dados como o árbitro autoritativo. As equipes de engenharia devem projetar o serviço de registro para capturar exceções de violação de índice único explicitamente. Ao traduzir erros de conflito de banco de dados em eventos de domínio ou códigos de status claros, o serviço mantém um alto throughput sem bloquear tabelas ou corromper relacionamentos de contas.
Perguntas frequentes
Por que as restrições de unicidade do banco de dados sozinhas são insuficientes para prevenir registros duplicados de usuários?
As restrições de unicidade impedem de forma confiável linhas duplicadas no banco de dados, mas atuam apenas no final do ciclo de vida da transação. Depender inteiramente de colisões de banco de dados força o motor de armazenamento a processar registros malformados, não padronizados ou ruidosos. Integrar a normalização pré-envio e a verificação de metadados upstream reduz a carga desnecessária no banco de dados, padroniza variações de entrada e permite que as equipes resolvam problemas de validação antes que ocorram erros no banco de dados.
Como os metadados de alocação da operadora original informam os fluxos de trabalho de registro?
Os metadados de alocação da operadora original fornecem contexto estático de atribuição de rede, tipo de linha e geografia de numeração regional para um identificador. Ao consultar esses dados de alocação por meio de verificações síncronas, as equipes de engenharia obtêm contexto estrutural sobre a faixa de números de telefone. Esse contexto apoia a triagem automatizada de tráfego e decisões de roteamento interno juntamente com a validação primária do banco de dados.
Qual é o papel da normalização E.164 na integridade dos dados?
A normalização de números converte números de telefone no formato padronizado especificado pela ITU-T Recommendation E.164, compreendendo um código de país e até quinze dígitos. A normalização evita entradas duplicadas causadas por entradas inconsistentes do usuário, como espaços extras, traços ou prefixos nacionais, garantindo que os identificadores correspondam consistentemente às restrições de unicidade do banco de dados.
Saiba mais
Escolha as informações do produto que se encaixam na próxima etapa do seu fluxo de trabalho.