Unir un CSV de Carrier Lookup a filas de contacto originales
Guía práctica para unir un CSV de Carrier Lookup con filas de contacto originales, incluyendo límites de solicitud y pasos de revisión para equipos de datos.
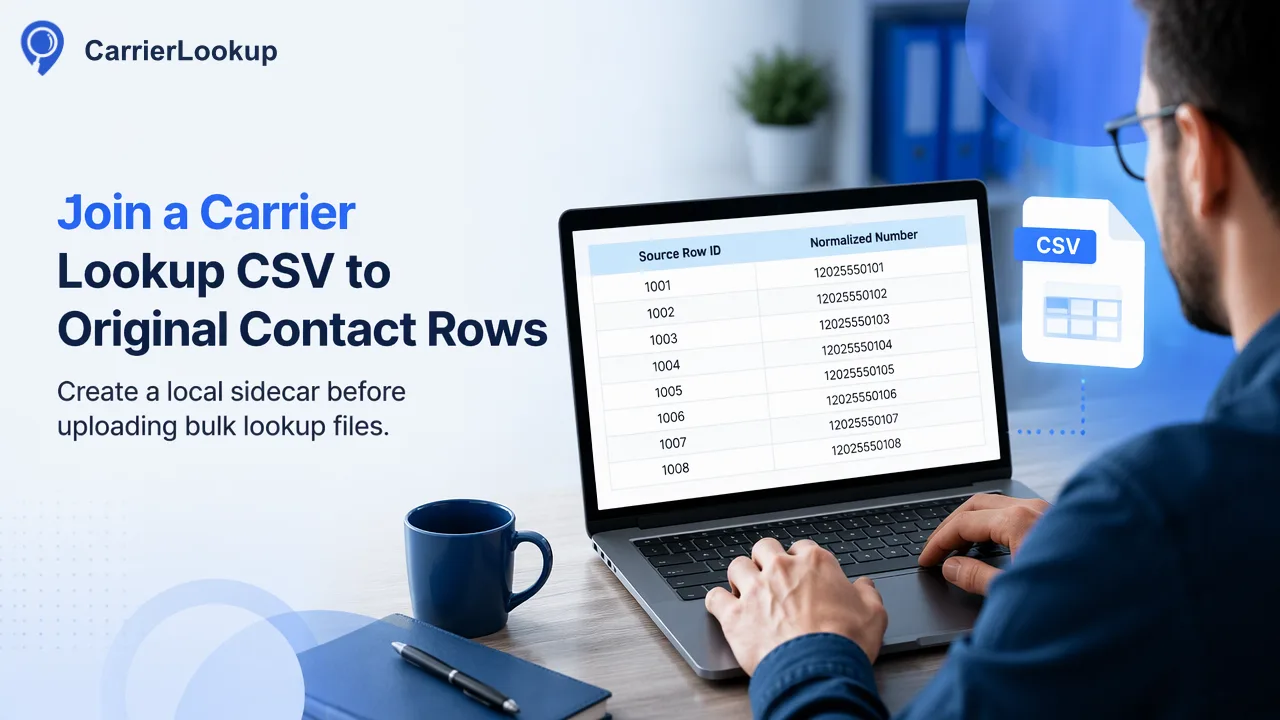
Para unir un CSV de Carrier Lookup con los registros de contacto, cree un archivo auxiliar local antes de realizar la carga: asigne cada número preparado con código de país a cada ID de fila de contacto original que lo proporcionó.
Para unir un CSV de Carrier Lookup con los registros de contacto, cree un archivo auxiliar local antes de realizar la carga: asigne cada número preparado con código de país a cada ID de fila de contacto original que lo proporcionó. Envíe únicamente los identificadores preparados para el país seleccionado y, a continuación, concilie el CSV devuelto por identificador en lugar de por la posición de la fila en el archivo. Esto preserva los contactos duplicados sin pretender que el servicio masivo devuelva una fila por cada registro de origen.
Prepare el archivo auxiliar antes de crear el archivo masivo
La Consulta del operador original en tiempo real de CarrierLookup devuelve el operador asignado originalmente, el operador subyacente, el tipo de número y la geografía de asignación. Su producto independiente de búsqueda de operador global gestiona las tareas de archivo asíncronas. La página de Global carrier lookup es la ruta del producto pertinente. La carga masiva acepta TXT o CSV de una sola columna con un número con código de país en cada línea y un país ISO seleccionado. El archivo preparado debe ser esencialmente para ese país seleccionado. No asuma que el producto acepta XLSX, esquemas mixtos o un archivo que contenga IDs de fila de CRM.
Una exportación de CRM de origen puede contener números repetidos, diferentes formatos de visualización, valores en blanco y números fuera del país previsto. Antes de enviarlo, cree una asignación local desde el número canónico con código de país a una lista de IDs de fila de origen. Mantenga el texto original y la decisión de normalización junto a cada fila para su auditoría. Por ejemplo, dos contactos pueden compartir un número de centralita empresarial; el archivo auxiliar debe preservar ambos IDs de fila incluso si la lista enviada contiene ese número una sola vez. Esta es una estructura de datos propiedad del cliente, no una columna devuelta por el producto masivo.
Separe una fila de origen rechazada de un identificador preparado excluido. Una fila puede ser inutilizable antes de la carga porque carece de suficiente contexto para normalizarse, mientras que el preprocesamiento masivo puede excluir posteriormente duplicados o números fuera del país seleccionado. Registre la etapa claramente.
Utilice el significado del identificador, no la posición de la fila, como clave de unión
Una tarea masiva exitosa devuelve un CSV con un identificador y campos de asignación original. Los identificadores masivos son dígitos con código de país sin signo más ni espacios. El CRM de origen puede almacenar números E.164 con un signo más inicial, formato nacional o puntuación. Normalice ambos lados en la misma forma de comparación propiedad del cliente antes de unirlos, mientras conserva cada representación original por separado. No asuma que el orden de las filas del CSV coincide con el orden de las filas de contacto; el preprocesamiento puede excluir entradas no válidas o duplicadas.
La unión es de varios a uno: varias filas de contacto pueden apuntar a un número preparado y a una fila de búsqueda devuelta. Expanda el resultado de nuevo a esas filas de origen solo después de validar la clave. Por el contrario, si un identificador devuelto está ausente del manifiesto enviado, póngalo en cuarentena para su revisión en lugar de adjuntarlo a la fila más cercana. Esta es una regla de conciliación, no una afirmación de que las filas inesperadas sean un comportamiento normal del producto.
Un manifiesto compacto puede contener el ID de fila de origen, el texto original del teléfono, el valor de comparación normalizado, el país seleccionado, el nombre del archivo preparado y la referencia del lote de envío. Estos son campos de metadatos locales. No deben anunciarse como columnas CSV de CarrierLookup. La API documentation debe utilizarse para el envío de tareas actuales y los detalles de los resultados.
Compruebe las exclusiones y duplicados antes de actualizar los registros
El preprocesamiento masivo excluye filas no válidas, duplicados, números sin código de país y números fuera del país seleccionado. Las filas excluidas no se cobran. Es por esto que el recuento de filas de carga, el recuento de válidos preparados y el recuento de resultados pueden diferir. Concílelos como tres cantidades separadas. No rellene el operador de una fila excluida a partir de una línea de salida adyacente. Si contactos de origen duplicados comparten un número normalizado, la aplicación puede asignar el único resultado completado a ambos, con el mismo tiempo de observación y origen.
Una tarea puede fallar durante la preparación si se estima que hay muy pocos números móviles válidos o si falla otra condición de aceptación. En ese caso, no cree filas de resultados fantasma a partir del archivo de entrada. Mantenga el manifiesto para el diagnóstico y consulte la documentación del producto para conocer los límites actuales por producto. Este artículo no indica intencionadamente un mínimo, máximo o tiempo de finalización normal de la tarea. La tarea masiva es asíncrona, por lo que debe esperar al éxito antes de utilizar su CSV.
Los campos CSV describen la asignación original, no el operador actual después de la portabilidad numérica. La región y la ciudad son la geografía de asignación de rangos, no la ubicación de un contacto. Una fila completada con campos de asignación vacíos debe seguir siendo una fila completada con valores no disponibles, no descartarse como una unión no válida.
Produzca un informe de conciliación antes de la escritura en el CRM
El informe final propiedad del cliente debe enumerar los identificadores únicos enviados, los identificadores devueltos, las claves enviadas no coincidentes, las claves devueltas inesperadas, las filas de origen cuyos números fueron rechazados antes de la carga y las filas de origen duplicadas que recibirán el mismo resultado. Un revisor debe aprobar la política de unión para los casos no coincidentes antes de que comiencen las escrituras. Mantenga el CSV sin procesar y el archivo auxiliar bajo la política de acceso y retención de la propia organización para que una auditoría posterior pueda reproducir la asignación.
Para cada actualización de CRM, compruebe que el contacto todavía tenga el mismo número normalizado. Si cambió mientras se ejecutaba la tarea, marque un conflicto en lugar de sobrescribir el registro actual con un contexto de operador obsoleto. Una comprobación de versión de registro opcional puede ayudar a la integración del cliente a aplicar esa regla; no es una característica de CarrierLookup. Almacene el origen de la búsqueda y el tiempo de observación con los campos de asignación original.
Después de una prueba, muestree un número repetido, un número excluido durante la preparación, un resultado de campo vacío completado y un contacto editado durante la tarea. Los resultados esperados son, respectivamente, una expansión deliberada de varios a uno, ningún resultado de operador inventado, valores vacíos preservados y un conflicto diferido. Esta validación se dirige al riesgo real de un flujo de trabajo de archivos: asignar una búsqueda técnicamente correcta al contacto equivocado.
Si una fila de origen contiene varios campos de teléfono, registre qué campo generó cada identificador preparado. Un número de contacto principal y un número alternativo no deben recibir valores de operador intercambiables. El archivo auxiliar puede explicar entonces por qué una fila CSV completada actualizó un campo pero dejó el otro intacto, incluso cuando ambos valores pertenecen al mismo registro de persona o empresa.
Preguntas frecuentes
¿Deben los equipos unir las filas CSV masivas por posición?
No. Utilice el identificador con código de país devuelto y una asignación de archivo auxiliar local a los IDs de fila de origen; el preprocesamiento puede eliminar filas.
¿Cómo deben manejarse los contactos duplicados con un número de teléfono?
Preserve cada ID de fila de origen en el archivo auxiliar, envíe el identificador preparado una vez cuando sea apropiado y asigne deliberadamente el resultado completado a cada fila coincidente.
¿Qué sucede con un número excluido durante la preparación?
Manténgalo en un informe de exclusión y no invente un resultado de operador para esa fila de origen.
¿Puede el CSV mostrar la red o ubicación actual de un contacto?
No. Informa sobre el operador original y la geografía de asignación del rango de números, que no son hechos sobre la red actual o la ubicación de la persona.
Más información
Elija la información del producto que se ajuste al siguiente paso de su flujo de trabajo.