Python 中的原始归属运营商查询 API:使用 requests 进行单次和批量请求
了解如何使用 Python 的 requests 库调用原始归属运营商查询 API,包括单次和批量请求、结果映射、空值处理及余额查询。
本文介绍了如何使用 Python 的 requests 库执行单次和批量原始归属运营商查询,包括错误处理以及将有序结果映射回原始数据行的方法。
要使用 Python 调用原始归属运营商查询 API,请使用 requests 库向 /api/v1/check 发送 POST 请求以获取单个结果,或向 /api/v1/batch-check 发送包含最多 100 个号码的列表以获取一组有序结果。请务必从受信任的服务器发送带有 X-API-Key 请求头的 API 密钥,设置超时时间,在读取数据前检查响应代码,并根据位置和标识符将批量结果映射回您的数据行。返回的运营商信息为号码的原始分配信息,而非当前网络。
设置用于运营商查询的 requests 会话
requests 库 可以简化 HTTP 调用,通过使用会话对象,可以让所有调用共享请求头和连接。请使用 pip install requests 进行安装,并通过读取环境变量的方式获取密钥,以避免将其硬编码在源代码中。
import os
import requests

BASE_URL = "https://carrierlookup.online"

session = requests.Session()
session.headers.update({
    "X-API-Key": os.environ["CARRIERLOOKUP_API_KEY"],
    "Accept": "application/json",
})
从一开始就养成以下三个习惯:
- 仅在您控制的受信任服务器、工作节点或笔记本环境中运行此代码。切勿在浏览器或移动应用中发布密钥。
- 始终为每个调用传递
timeout参数。如果不设置,requests 可能会无限期等待。 - 在发送任何内容前,将号码标准化为 E.164 格式:包含前导加号、国家代码和用户号码,且不含空格或分隔符。
一个简单的辅助函数(用于去除分隔符并添加加号)可以节省大量重复的清理工作,并防止格式问题进入结果中。被拒绝的格式属于格式问题,而非运营商查询结果,因此请在请求前处理好格式。
发送单次查询至 /api/v1/check
实时单次查询的接口为 POST /api/v1/check。它接收一个 E.164 号码并立即返回响应。请按照 API 文档的说明将号码放入 JSON 请求体中。
def check_one(number: str) -> dict | None:
    resp = session.post(
        f"{BASE_URL}/api/v1/check",
        json=build_single_payload(number),  # 请求体结构:请参阅 API 文档
        timeout=65,
    )
    resp.raise_for_status()
    body = resp.json()
    if body.get("code") != 0:
        print("未完成:", body.get("msg"))
        return None
    return body["data"]
响应体包含 code、msg 和一个扁平的 data 对象。code 为 0 表示查询已完成。数据中包含原始运营商、底层运营商、号码类型、国家代码、地区和城市。任何可选值都可能为空,即使所有运营商相关值均为空,这也属于正常的完成结果。请将空值存储为“不可用”,而不要将其视为号码没有运营商的证明。
非零的 code 表示查询未完成,例如无法判定结果的情况。请勿将此类情况视为成功的空结果。失败或无法判定的查询不会扣费,因此进行短时间延迟后的重试是合理的。公共文档列出了实时调用的超时上限,请将您的客户端超时时间设置为等于或高于文档中单次请求的上限。
发送批量请求并将结果映射回数据行
当您有少量号码需要查询时,POST /api/v1/batch-check 可接收 1 到 100 个 E.164 号码,并返回有序的同步结果。这些号码可以来自不同国家。响应会汇总总数、成功数和失败数,并按输入顺序逐一列出结果。
def check_many(numbers: list[str]) -> list[dict]:
    resp = session.post(
        f"{BASE_URL}/api/v1/batch-check",
        json=build_multi_payload(numbers),  # 请求体结构:请参阅 API 文档
        timeout=310,
    )
    resp.raise_for_status()
    body = resp.json()
    if body.get("code") != 0:
        raise RuntimeError(body.get("msg"))
    return body["data"]["results"]
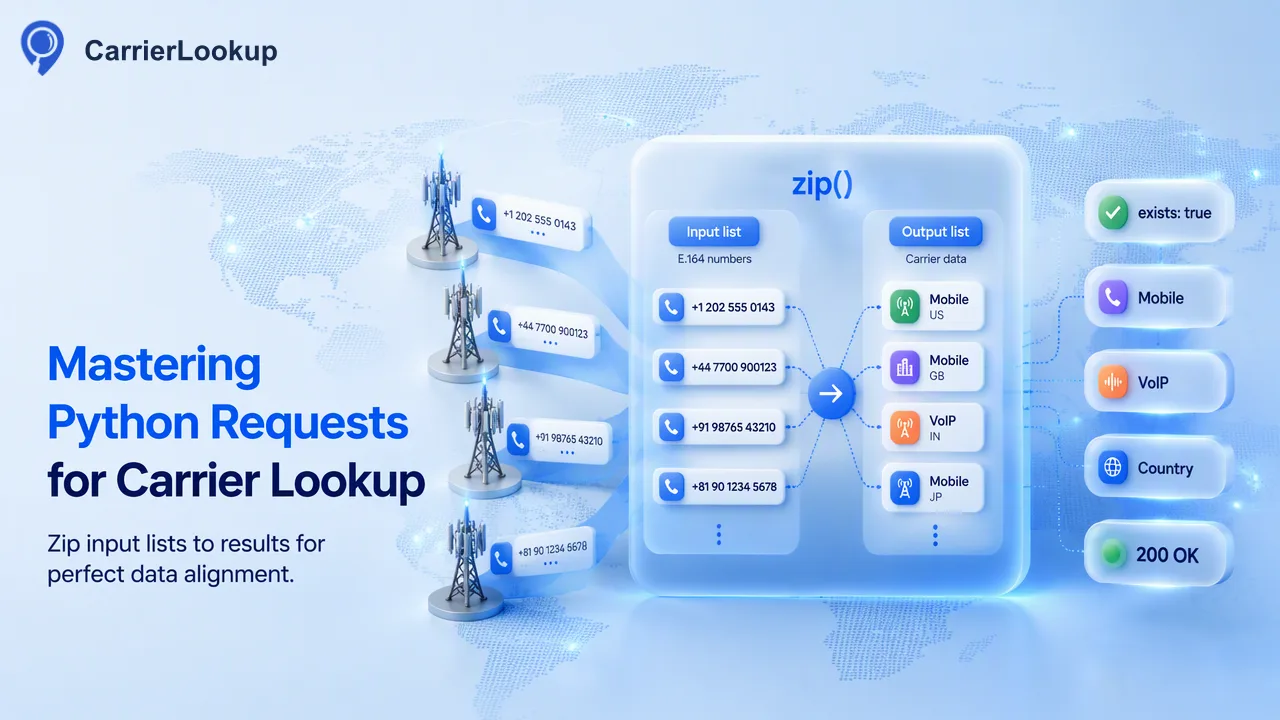
要将结果附加到您的数据行,请将输入列表与结果列表进行 zip 操作,并检查每个项目的标识符是否与您发送的号码匹配。第二次检查可以防止在构建和发送请求之间列表发生变动时出现静默错位。
每个项目还包含一个 exists 标志。当该标志为 false 时,表示该项目没有正常结果。这与无效或已停机号码不同,请将其存储为“无结果”,并稍后决定是重试还是跳过。如果批量请求超时,整个请求将失败且无部分结果,且不会扣费,因此安全的做法是重试同一批次。
每个账户一次只能运行一个批量请求,因此处理分块的循环应等待上一个调用完成后再发送下一个。
分块、重试与余额检查
实际列表通常超过 100 个号码,因此请将其拆分为多个块并依次处理。
def chunks(items, size=100):
    for i in range(0, len(items), size):
        yield items[i:i + size]

rows = []
for part in chunks(clean_numbers):
    rows.extend(check_many(part))
以下几条实用规则可确保循环的可靠性:
- 先对清理后的列表进行去重,确保每个号码只查询一次。
- 将
requests.exceptions.Timeout和ConnectionError与 API 错误分开捕获,并进行有限次数的带间隔重试。 - 保持较低的并发度。公共文档描述了有限的共享实时并发槽位,且未发布固定的每分钟上限,因此请避免启动大量并行线程。
- 在每个分块返回后立即将其写入磁盘或数据库,以防程序崩溃导致已完成的工作丢失。
在大规模运行前,请调用 GET /api/v1/balance。它可以在不扣费的情况下读取账户余额,让脚本在余额不足时提前停止并给出明确提示,而不是在运行中途失败。实时查询和文件服务共享同一个余额,并按已完成的号码计费。
对于远超几个分块的超长列表,异步文件任务比长循环的同步调用更合适。文件任务是一个具有独立端点的工作流,而非批量请求的简单放大版。
负责任地解读结果
一旦数据进入 pandas 数据框或数据库,主要的风险在于过度解读。运营商信息是指号码段最初分配的运营商。在携号转网后,用户可能使用其他运营商。地区和城市描述的是号码分配的地理位置,而非用户或手机当前所在位置。号码类型仅告知号码段的种类,而非线路是否处于活跃状态。
合理的用途包括:为运营商路由测试对记录进行分组、标记异常号码类型以供审查,以及为 CRM 添加上下文列。不合理的用途包括:判定号码是否可达、推测号码所有者或推断营销许可。
一个简单的架构可以保持含义清晰:原始运营商、底层运营商、号码类型、国家代码、地区、城市、查询状态和查询时间。状态列用于区分已完成、空值和失败的结果,以便后续报告不会混淆这些情况。
常见问题解答
哪种 Python 库最适合调用运营商查询 API?
requests 库足以胜任单次和批量端点的调用。请使用会话来共享 API 密钥请求头,始终设置超时时间,并调用 raise_for_status 以及检查响应代码。对于大量并发任务,请保持连接池较小,因为实时槽位是全账户共享的。
团队如何将批量结果映射回输入行?
结果按输入顺序返回,且每个项目都会重复发送时的标识符。请将输入列表与结果进行 zip 操作,并在写入数据前验证每个标识符是否与对应的行匹配。exists 标志为 false 的项目应存储为“无正常结果”,而非无效号码。
API 密钥应存放在 Python 项目的什么位置?
请将其存放在受信任服务器的环境变量或密钥管理服务中,并在启动时读取。不要将其提交到源代码管理中,也不要从浏览器或移动端代码中发送。如果密钥泄露到日志或仓库中,请立即轮换并审查近期使用记录。
了解更多
选择符合您工作流下一步的产品信息。