在您的 CRM 电话数据样本上测试原始归属运营商查询
通过具有代表性的电话样本、字段级参考检查以及针对未知数据和审查工作的诚实记分卡,开展原始归属运营商信息丰富化试点。
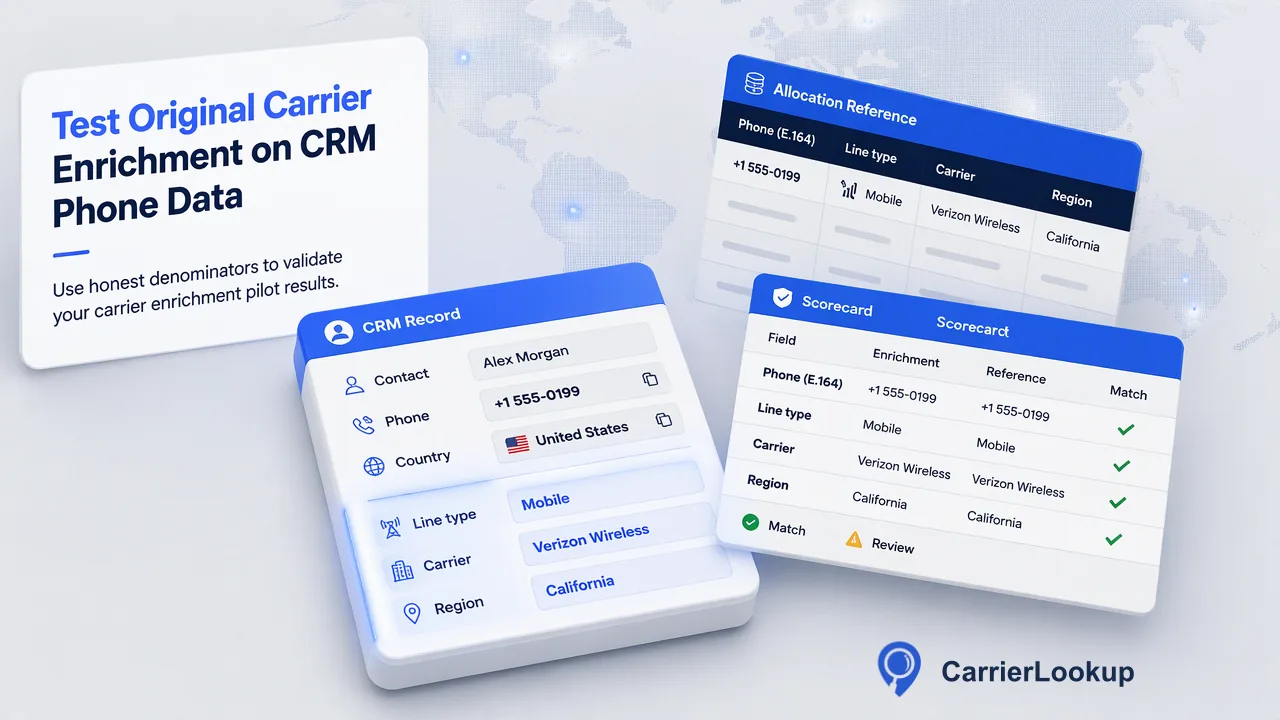
运营商信息丰富化试点应测试团队将要使用的确切分配字段和 CRM 决策,并明确缺失数据和冲突数据的分母。
为了评估运营商信息丰富化,请从您的团队实际处理的国家/地区、格式和线路类型中抽取授权的 CRM 电话记录样本。将返回的原始分配字段与合适的分配参考数据进行比较,而不是与当前网络观测结果进行比较。分别统计被拒绝的输入、字段为空的已完成记录以及存在冲突的参考数据。围绕数据所支持的 CRM 操作设定验收标准,而不是基于供应商的通用准确性声明。
选择 CRM 决策和具有代表性的样本
CRM 所有者可能希望在数据清理项目之前,为现有的电话记录添加原始运营商和线路类型背景信息。有意义的问题不是 API 是否报告了较高的全局准确率,而是该团队自身的记录是否获得了员工可以正确解读并据此采取行动的字段。首先写明预期用途:向分析师显示分配背景、对记录进行分组以供人工审查,或确定哪些输入行需要格式修复。请勿将运营商字段作为可送达性、当前网络、所有权或同意情况的代理指标。
CarrierLookup 的原始归属运营商查询产品报告号码段最初分配到的运营商,并在可用时提供号码类型和分配地理位置。它不会追踪携号转网后的当前服务网络。对于小型试点,请使用记录在案的单次或同步多次 REST 检查,而不是准备生产规模的文件任务。选择您有权处理的 CRM 行,保留内部行 ID 和原始电话值。将工作副本标准化为 E.164 格式以供实时 API 使用,并将被拒绝或无法解析的输入保留在试点分母中。
按业务相关的国家/地区和记录来源、已知的格式质量,以及您拥有可靠参考数据的预期移动、固定线路或其他线路类型案例对样本进行分层。如果这些来源的质量存在差异,请包含旧的导入数据和近期记录。仅靠随机抽取可能会掩盖小而重要的国家/地区切片;而手动挑选一组简单的号码可能会使试点看起来比最终的工作负载效果更好。报告每个切片的计数,不要将此样本转化为关于所有国家/地区的声明。
在评分前建立原始分配参考
参考数据必须回答与产品字段相同的问题。当前的订阅者网络结果、最近的通话结果或销售代表的备注无法确定号码段的原始运营商。对于抽样号码,请寻求相关的号码分配记录或其他记录在案的原始分配来源,并记录其日期和范围。当某一行没有可信的参考数据时,将其标记为“无法判定”,而不是将提供商视为正确或错误。对于地区和城市,请比较号码分配地理位置,而不是联系人的当前位置。
审查员应标注哪些字段具有一致的参考数据:原始运营商、相关时的底层运营商、号码类型、国家代码、地区和城市。API 文档将这些列为运营商结果字段;可选值可能为空。保存每个参考数据的来源和审查日期,因为分配表和 CRM 自身的元数据可能使用不同的名称或详细程度。在计算匹配项之前,请定义运营商名称的标准化规则。否则,拼写差异或母品牌别名将被计为不正确的数据,而实际上并无实质性分歧。
如果两个可信来源发生冲突,请将冲突保留为单独的审查案例。不要盲目选择与供应商一致的标签。检查来源是否描述了不同的日期、原始网络与当前网络,或宿主网络与品牌。小型试点可能会揭示团队的参考集与信息丰富化本身一样需要改进。即使这妨碍了简单的准确率计算,这对做出采用决策也是有用的。
使用带有诚实分母的字段级记分卡
对于每一行输入,记录格式状态、请求状态、完成的查询状态、返回的字段值、参考数据的可用性以及审查员的决定。被拒绝的 E.164 输入不是运营商查询失败。传输超时不是空的已完成结果。成功的 code-zero 响应但可选运营商字段为空,属于已完成查询但数值不可用;它仍然可能被计费。对于同步多次检查,没有正常结果的项目应与有效的负面解释保持区别。
| 衡量指标 | 分母 | 决策参考 |
|---|---|---|
| 输入接受度 | 所有抽样的授权 CRM 行 | 数据需要多少准备工作 |
| 已完成查询覆盖率 | 已接受的请求 | 样本中有多少产生了正常结果 |
| 原始运营商一致性 | 具有可信原始分配参考的已完成行 | 该字段对于此用途是否可靠 |
| 字段可用性 | 每个国家/地区或来源切片中的已完成行 | 分析师是否拥有可用的背景信息 |
| 人工审查工作量 | 需要解读或冲突解决的行 | 工作流程是否节省了工作量 |
报告原始计数以及百分比。总体一致率不应将没有参考数据的行、请求失败和真正矛盾的运营商标签合并计算。分别列出缺失运营商、缺失号码类型和缺失地理位置的情况,因为它们具有不同的业务后果。CRM 信息丰富化测试比较讨论了样本覆盖率和正确性;此记分卡为此特定服务增加了必要的原始分配参考和字段级核算。
选择与业务操作挂钩的验收标准
在查看记分卡之前,请确定对于拟议的 CRM 用途来说,什么样的结果是“可用”的。如果数据仅作为背景显示,团队可以容忍缺失的可选字段,只要它们被明确标记为“无法判定”。如果规则将根据号码类型自动路由记录,请检查该特定字段的差异率和未知率,并为异常情况设置人工处理路径。根据您的工作负载和错误后果设定阈值,而不是基于通用基准。关于 B2B 信息丰富化基准的讨论同样警告称,细分市场和字段差异隐藏在广泛的声明背后;其数据并非 CarrierLookup 的性能数据。
考虑一个具有多个来源系统的假设试点。一个来源可能有许多格式错误的号码,而另一个来源有干净的 E.164 条目但原始分配参考较弱。不要将前者归结为提供商错误,也不要将后者归结为已证实的准确性。一个有用的结果可能是先清理输入格式再购买更多查询,或者在推迟自动化的同时将返回的运营商作为审查背景。记录每个决定和剩余的不确定性。试点还应根据当前的定价条款估算已完成查询的成本,不要假设可选字段为空是免费的。
如果样本支持预期用途,请从有限的工作流程开始,并根据相同的参考规则比较后续的异常情况。如果不支持,请在扩展之前更改字段用途或样本设计。打开 CarrierLookup API 文档,选择一个小型的授权 CRM 样本,并首先填写参考和操作列;然后再运行检查。
了解更多
选择适合您工作流程下一步的产品信息。