在 BigQuery 中将电话号码标准化为 E.164 以进行查询
在进行原始归属运营商查询之前,需在 BigQuery 中将电话号码标准化为 E.164。请保留原始列,在工作列中去除呈现字符,并仅在有权威国家/地区字段支持时添加国家代码。
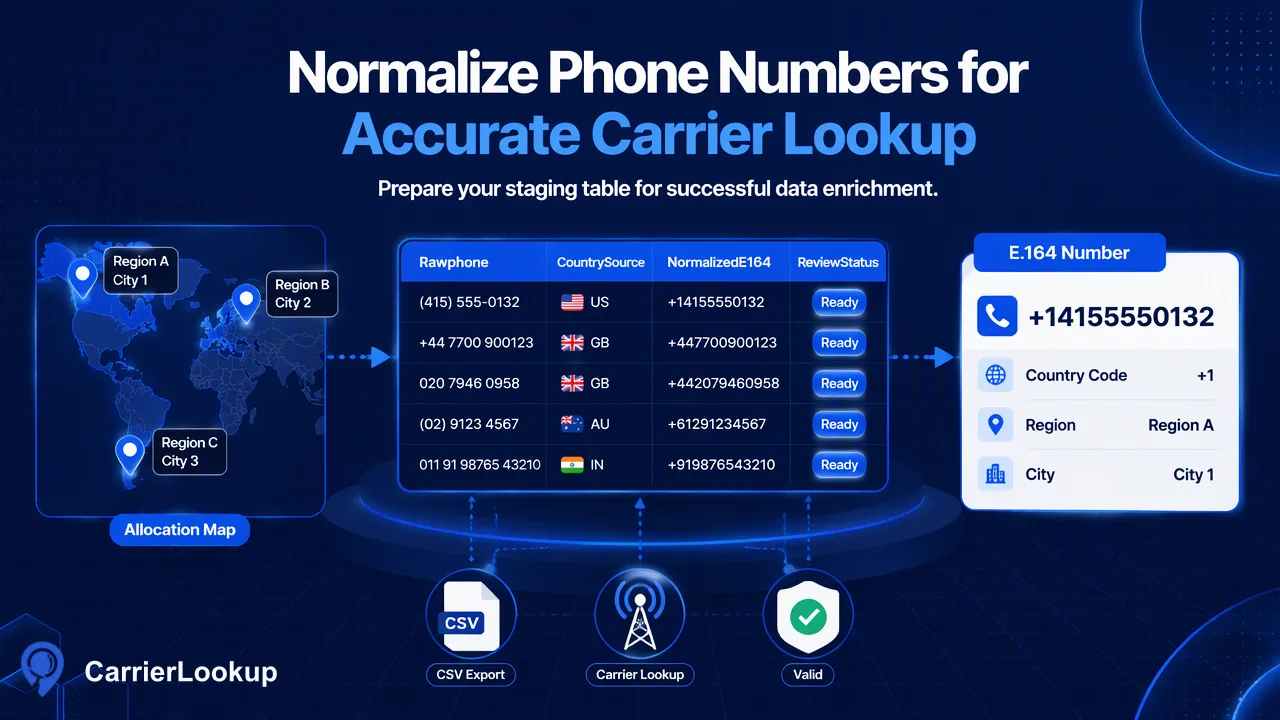
若要将电话号码标准化为 E.164,请在 BigQuery 中进行处理。
在进行原始归属运营商查询之前,需在 BigQuery 中将电话号码标准化为 E.164。请保留原始列,在工作列中去除呈现字符,并仅在有权威国家/地区字段支持时添加国家代码。对于 CarrierLookup 实时请求,请保留前导加号。对于单国家/地区文件任务,请导出带有国家代码的数字,并使用稳定键对返回的 CSV 进行核对。
保留原始号码及其国家/地区证据
在清理过程中,请勿覆盖电话号码的唯一副本。应为原始值、来源国家/地区、标准化候选值以及拒绝或人工审核原因创建单独的列。来源数据可能包含国内拨号前缀、本地格式或书写不一致的国家代码。正则表达式可以删除标点符号,但无法判定号码所属的国家/地区。该判定需要可靠的国家/地区字段或其他授权的来源证据。
ITU E.164 recommendation 定义了国际编号结构。CarrierLookup 实时检查要求使用前导 +、国家代码和用户号码,且不得包含空格或分隔符。仅看起来像数字的候选值并不自动等同于有效号码。在人工审核或经过验证的编号规则解析之前,请勿将不确定的值纳入查询集。
请在开始时规划导出格式。实时多号码请求可以包含来自不同国家的号码,并按输入顺序返回结果。CarrierLookup 的批量文件任务接受来自一个选定国家的号码。在准备文件之前,请按可靠的国家/地区分配拆分混合国家/地区的数据集;切勿仅根据前几位数字选择国家/地区。
使用 BigQuery 函数进行机械清理
Google 的 BigQuery string-function reference 文档介绍了 REGEXP_REPLACE、REGEXP_CONTAINS 及相关函数。请使用它们进行机械转换,例如从源值的副本中删除空格、括号和连字符。像 REGEXP_REPLACE(raw_phone, r'[^0-9+]', '') 这样简单的表达式可以创建检查候选值,但它也可能保留意外的内部加号。请在执行后进行格式测试并设置隔离路径,而不是将所有输出发送到 API。
对于已经存储了可靠前导加号和国家代码的数据,候选表达式可以在保留加号的同时去除分隔符。对于本地号码,请使用根据当前编号指南审查过的特定国家/地区标准化规则。当原始值已经包含国家代码或主干前缀时,通用的“添加 CRM 国家代码”规则存在风险。请记录应用于每种源类型的具体转换,并在导出前对输出进行抽样检查。
一个实用的暂存表应包含 raw_phone、country_source、normalized_e164、normalization_rule 和 review_status。仅根据标记为就绪的行构建查询输入。这可以防止将拒绝的格式误认为是无运营商结果,并使更正过程可逆。
准备实时多号码路径
对于少量就绪集,请将 E.164 字符串(即 + 后跟带国家代码的数字)导出到 REST 多号码工作流。POST /api/v1/batch-check 端点接受 1–100 个号码并返回有序的同步结果。在发送调用之前,请存储从请求元素到源行键的位置映射。当 CRM 包含重复项时,请勿仅依赖相同的电话值。
读取每个返回项的 identifier 和 exists 状态。exists=false 表示该项没有正常结果;这并不代表该号码已断开连接。成功的结果可能包含运营商、底层运营商、号码类型、国家代码、地区和城市,可选字段可能为空。请在暂存表中保留每个结果的检查时间和输入关联。
当操作员需要检查单个记录时,单次检查使用相同的 E.164 格式。请使用记录在案的 X-API-Key 标头从受信任的服务器进行身份验证。此工作流使数据团队能够在发送更大的准备列表之前,通过样本测试标准化效果。
准备单国家/地区文件任务
对于大型列表,请制作一个单列 TXT 或 CSV 文件,每行包含一个带国家代码的号码,并为批量任务选择相应的 ISO 国家/地区。记录在案的输入必须属于该选定国家/地区。在多部分提交中,国家/地区字段必须位于文件之前。批量准备工作会删除无效行、重复项、没有国家代码的行以及选定国家/地区之外的号码。在将源导出视为已完全处理之前,请检查准备计数。
批量任务是异步的:使用 POST /api/v1/bulk-tasks 提交,保存任务 ID,并以不超过每 30 秒一次的频率查询 GET /api/v1/bulk-tasks/{id}。成功的任务会提供一个 CSV 文件。它将标识符报告为不带加号的纯数字。这与实时请求格式不同,因此请勿通过直接字符串相等性将结果连接到原始电话字段。
从每个已接受的 E.164 候选值构建一个标准化的纯数字连接键,并单独保留源行键。如果输入包含重复号码,批量准备可能会合并它们;请决定是否应将一个结果关联到多个源记录。在结果 CSV 之外核对不匹配、无效和重复的源行。
在 CRM 更新前审查连接的数据
所得的运营商信息描述的是原始分配情况,而非携号转网后的当前服务运营商。地区和城市是分配地理位置,而非实时位置。请将这些描述放入数据字典中,以免分析师将字段名称误认为是人员当前所在位置的证明。code=0 的已完成实时结果可能包含为空的可选运营商字段;请将空值保留为无法判定,而不是生成负面标签。
从多个源系统和国家/地区抽样连接的行。检查原始号码、标准化 E.164 格式、纯数字键和结果标识符是否指向相同的输入。在将值写入 CRM 之前,请调查暂存表中的不匹配项。请保留查询时间戳,因为分配背景可能会在以后重新审视,且源记录本身可能会发生变化。
此流水线分离了三个作业:BigQuery 清理已知表示形式,CarrierLookup 提供记录在案的分配字段,CRM 团队决定是否以及如何更新联系人。这种分工使错误清晰可见,并使运营商结果保持在其适当的含义范围内。
常见问题解答
团队如何在 BigQuery 中去除电话分隔符?
使用工作副本和记录在案的字符串函数(如 REGEXP_REPLACE),然后根据预期的 E.164 形状验证候选值。
团队如何为本地号码分配国家代码?
使用可靠的国家/地区字段和经过审查的特定国家/地区规则。隔离国家/地区或拨号形式不明确的行。
团队如何将批量 CSV 连接到 E.164 输入?
从已接受的 E.164 候选值中创建一个稳定的纯数字键,并将其与批量 CSV 标识符进行核对,同时保留源行 ID。
团队如何处理混合国家/地区的列表?
对于少量混合国家/地区集,请使用实时多号码请求;或者在批量提交之前,按受信任的国家/地区分配拆分大型文件。
了解更多
选择符合您工作流下一步的产品信息。