Produktleitfaden
Jenseits von Regex: Implementierung robuster Telefonnummernvalidierung in React-Anwendungen
Erfahren Sie, warum Regex für die Validierung von Telefonnummern in React nicht ausreicht und wie Sie clientseitige Normalisierung mit Netzbetreiber-Metadaten kombinieren.
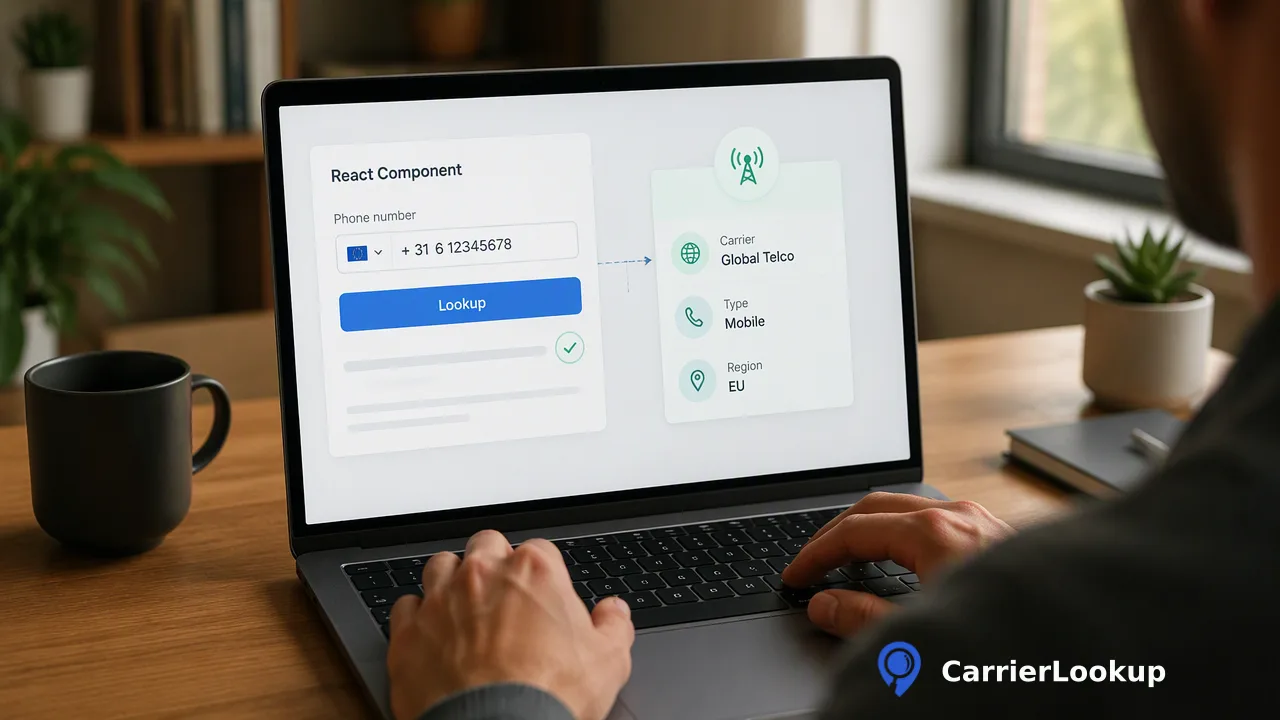
Entdecken Sie, warum clientseitige Regex und HTML5 für die internationale Telefonnummernvalidierung in React nicht ausreichen und wie Sie eine zuverlässige Datenpipeline unter Verwendung internationaler Formatstandards und serverseitiger Metadaten zur Netzbetreiberzuordnung aufbauen.
Clientseitige reguläre Ausdrücke und HTML5-Attribute bieten eine grundlegende Syntaxfilterung, sind jedoch für die globale Validierung von Telefonnummern in modernen Web-Workflows unzureichend. Robuste React-Implementierungen erfordern eine mehrschichtige Strategie zur Datenverarbeitung. Teams kombinieren eine standardisierte clientseitige Normalisierung mit serverseitigem Zuordnungskontext. Die Normalisierung von Nummern in internationale Formate stellt eine korrekte Ziffernstrukturierung über verschiedene nationale Konventionen hinweg sicher. Darüber hinaus liefert die Abfrage von Metadaten zur ursprünglichen Netzbetreiber- und Nummernblockzuordnung administrativen Kontext bezüglich Leitungstypen und geografischer Herkunft. Diese kombinierte Architektur hilft Unternehmen dabei, saubere Datensätze zu strukturieren, Onboarding-Workflows zu verbessern und nachgelagerte Routing-Prozesse zu unterstützen, ohne sich auf fehleranfällige, fest codierte Frontend-Ausdrücke zu verlassen.
Die Grenzen der clientseitigen Syntaxvalidierung
Clientseitige Formularsteuerelemente stützen sich häufig auf das HTML5-Attribut type="tel" oder clientseitige reguläre Ausdrücke. Während HTML5-Attribute mobile Browser dazu veranlassen, numerische Tastaturen anzuzeigen, bewertet die standardmäßige Browser-Validierung lediglich grundlegende Eingabemuster und keine tatsächlichen Telekommunikationsregeln.
Reguläre Ausdrücke führen zu operativer Instabilität, wenn sie auf globale Nummerierungspläne angewendet werden. Internationale Telekommunikationsstandards, wie die ITU-T Recommendation E.164, legen fest, dass Telefonnummern bis zu fünfzehn Ziffern umfassen können, mit variablen Ländervorwahlen und regionalen Teilnehmerstrukturen. Das Erstellen eines regulären Ausdrucks, der in der Lage ist, wechselnde internationale Präfixe, variable Längen von Ortsvorwahlen und unterschiedliche nationale Ziffernanzahlen zu parsen, schafft einen hohen Wartungsaufwand. Frontend-Regex-Prüfungen akzeptieren häufig mathematisch unmögliche Ziffernfolgen und lehnen gleichzeitig gültige ausländische Eingaben ab. Folglich fungieren clientseitige Syntaxprüfungen eher als einfache Eingabefilter denn als zuverlässige Validierungswerkzeuge.
Jenseits des Formats: Die Rolle der Zuordnungs-Metadaten
Die Formatvalidierung bestätigt, dass eine Eingabezeichenfolge einem strukturellen Muster entspricht, aber Unternehmensanwendungen profitieren von Telekommunikationskontext. Daten zur ursprünglichen Netzbetreiberzuordnung beschreiben das Netzwerk und die geografische Region, denen ein Telefonnummernbereich ursprünglich zugewiesen wurde.
Die Integration von Zuordnungssignalen reichert Benutzerdatensätze mit wesentlichen administrativen Attributen an:
- Nummerntyp: Identifiziert, ob die Sequenz zu einem Mobilfunk-, Festnetz- oder VoIP-Zuordnungsblock gehört.
- Ländervorwahl und Zuordnungsgeografie: Detailliert den nationalen Nummerierungsplan und die administrative Region, die mit dem Block verknüpft ist.
- Ursprünglich zugewiesenes Netzwerk: Identifiziert die anfängliche Netzbetreiberzuordnung für den Bereich.
In Umgebungen mit mehreren Anbietern übertragen Verbraucher häufig Nummern zwischen Anbietern, wie in den öffentlichen Richtlinien zu Porting: Keeping Your Phone Number When You Change Providers beschrieben. Das Verständnis der ursprünglichen Zuordnung bietet stabile Telemetrie für Datenklassifizierung, Risikobewertungsmodelle und regionale Analysen über Unternehmensdatensätze hinweg.
Architektur für Datenintegrität in React
Der Aufbau einer resilienten Datenpipeline in React beinhaltet die Entkopplung der Formatierung von Benutzereingaben von der serverseitigen Anreicherung. Auf der Clientseite formatieren Komponenten die Tastatureingaben der Benutzer in eine standardmäßige internationale Darstellung, indem sie eine Ländervorwahl voranstellen und Leerzeichen, Bindestriche sowie Klammern entfernen.
Sobald die Struktur im Standardformat vorliegt, leitet die Anwendung den Datensatz an einen sicheren Backend-Dienst weiter. Direkte Browseranfragen an Validierungs-APIs legen sensible Anmeldeinformationen offen; Backend-Proxy-Dienste schützen die Infrastruktur, während sie Geschäftsregeln anwenden. Das Backend ruft einen synchronen Prüfendpunkt wie POST /api/v1/check mittels einer autorisierten Server-zu-Server-Anfrage auf. Diese synchrone Prüfung verifiziert ursprüngliche Zuordnungseigenschaften, ohne komplexe Client-Bundles zur React-Laufzeit hinzuzufügen. Die Einhaltung administrativer Datenschutzprinzipien, wie die Datenminimierung gemäß GDPR Article 5 (Regulation (EU) 2016/679), stellt sicher, dass Datenpipelines nur die notwendigen Telekommunikations-Metadaten verarbeiten.
Praktische Anwendungen für Netzbetreiber-Kontext
Der Empfang von Zuordnungs-Metadaten in Echtzeit ermöglicht es Produktteams, Entscheidungen beim Benutzer-Onboarding zu automatisieren und Back-Office-Workflows zu optimieren. Anstatt jede übermittelte Telefonnummer identisch zu behandeln, können Systeme Leitungs- und geografische Daten dynamisch parsen.
Operative Teams nutzen diese Daten in mehreren operativen Bereichen:
- Warteschlangen-Priorisierung: Organisationen leiten Konten, die mit bestimmten Leitungstypen verknüpft sind, wie z. B. feste VoIP-Blöcke, an erweiterte Identitätsprüfungs-Warteschlangen weiter.
- Geografisches Routing: Regionale Support-Teams erhalten eingehende Anfragen, die automatisch nach Ländervorwahl und Zuordnungsregion geroutet werden.
- Datenqualitätsfilterung: Datenbank-Import-Jobs markieren strukturell fehlerhafte Nummern oder unvollständige nationale Präfixe, bevor Datensätze die Kern-CRM-Tabellen erreichen.
Die Anreicherung von Datensätzen mit dem ursprünglichen Netzbetreiber-Kontext unterstützt interne Entscheidungsfindungen, rationalisiert die Kontenverwaltung und bietet skalierbare Grundlagen für den internationalen Kundensupport.
FAQ
Warum reicht Regex nicht für die Telefonnummernvalidierung aus?
Reguläre Ausdrücke bewerten Zeichenfolgenmuster, verfügen jedoch nicht über Kenntnisse internationaler Telekommunikations-Nummerierungspläne. Telefonnummern variieren zwischen Ländern in Länge, Stammnummern-Präfixen und regionalen Wahlregeln. Ein regulärer Ausdruck, der erfolgreich mit einer Jurisdiktion übereinstimmt, lehnt oft gültige Eingaben aus einer anderen ab. Darüber hinaus bestätigt die Mustererkennung die Syntaxstruktur, ohne Kontext bezüglich Leitungstyp, Netzbetreiberzuordnung oder geografischer Herkunft zu liefern.
Was ist der Unterschied zwischen dem aktuellen Netzbetreiber und der ursprünglichen Netzbetreiberzuordnung?
Die ursprüngliche Netzbetreiberzuordnung identifiziert den Telekommunikationsbetreiber, dem ein spezifischer Telefonnummernblock gemäß nationalen Regulierungsplänen ursprünglich zugewiesen wurde. Im Gegensatz dazu spiegelt der aktuelle Netzbetreiberstatus den aktiven Dienstanbieter wider, nachdem ein Kunde seine Nummer portiert hat. Die ursprüngliche Zuordnung bietet historischen Netzwerkkontext und Leitungstyp-Zuweisung und dient als administratives Datenattribut anstelle eines Live-Netzwerk-Routing-Signals.
Wie verbessern Netzbetreiber-Metadaten die CRM-Datenqualität?
Netzbetreiber-Zuordnungs-Metadaten fügen Kundendatensätzen strukturierte Felder hinzu, einschließlich Nummerntyp, Ländervorwahl und regionaler geografischer Zuweisungen. CRM-Systeme verwenden diese Attribute, um Kontakte zu kategorisieren, internationale Leads an die entsprechenden Vertriebsbüros zu leiten und synthetische Einreichungen zu filtern. Ein konsistenter Zuordnungskontext unterstützt standardisierte Datenmodelle, reduziert die manuelle Bereinigung von Datensätzen und verbessert die Konsistenz der Unternehmensberichterstattung über globale Datensätze hinweg.
Mehr erfahren
Wählen Sie die Produktinformation, die zum nächsten Schritt in Ihrem Workflow passt.